Serie Chaterimo CX-LLM Benchmark · edizione 2026 Q3
Ricerca · Modelli LLM
Migliore IA per l'assistenza clienti: 12 modelli alla cieca
ChatGPT, Claude, Gemini e Grok su 45 domande reali di assistenza clienti nell'e-commerce, valutati alla cieca da un modello giudice IA. Edizione 2026 Q3.
Risultati chiave
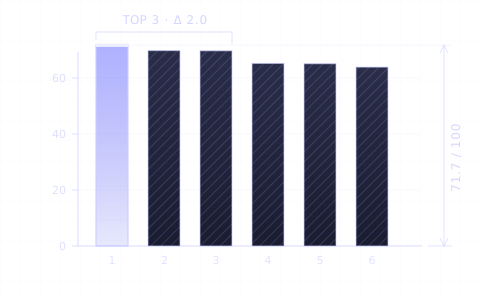
- 01Nel round 4 (30 agosto 2026) i tre modelli ChatGPT 5.6 sono in testa con 71,7, 69,8 e 69,7 punti su 100.
- 02Tra i modelli selezionabili in Chaterimo il 19 ottobre 2026, Grok 4.1 Fast ha ottenuto il punteggio migliore (65,2) e ha risposto in media in 2,2 s.
- 03L'accuratezza è il criterio più debole per ogni modello: il migliore ha raggiunto 55,4, mentre nel tono tutti e dodici hanno ottenuto tra 81 e 90.
- 04I tempi di risposta medi vanno da 1,3 s (Gemini 3.5 Flash-Lite) a 49,7 s (Grok 4.6).
- Periodo dei dati
- Round 4, snapshot of 30 August 2026
Indice 11
Quale modello linguistico risponde meglio ai clienti di un negozio online? Nel round 4 del Chaterimo CX-LLM Benchmark, 12 modelli hanno risposto alle stesse 45 domande reali di assistenza clienti e un modello giudice IA li ha valutati alla cieca. I tre modelli ChatGPT 5.6 sono in testa con 69,7–71,7 punti su 100. Ogni modello ha ottenuto il punteggio più basso nell'accuratezza, cioè la quota di fatti corretti.
Metodologia
Le domande vengono da conversazioni reali di assistenza clienti nei negozi online che usano Chaterimo. Ogni modello riceve lo stesso prompt di sistema, lo stesso contesto dalla base di conoscenza e la stessa domanda. Le risposte vengono etichettate in forma anonima (Risposta A, Risposta B …) e valutate da un modello giudice. Nel round 4 il giudice era Gemini 3.1 Pro (preview) di Google, che non è uno dei 12 modelli testati, quindi nessun modello ha valutato le proprie risposte. Il round 1 ha usato giudici di OpenAI, Anthropic, Google e xAI, i round 2 e 3 giudici di OpenAI e Google.
Ogni risposta riceve un punteggio da 0 a 100 su sei criteri. Il punteggio complessivo è la loro media ponderata:
- Accuratezza (30%)
- I fatti su prodotti, prezzi e condizioni sono corretti?
- Rilevanza (20%)
- La risposta riguarda ciò che il cliente ha chiesto?
- Completezza (15%)
- Contiene tutto ciò che serve al cliente per decidere?
- Utilità (15%)
- Porta il cliente verso un acquisto o una soluzione?
- Tono (10%)
- È cordiale e professionale?
- Concisione (10%)
- È breve senza tralasciare nulla di importante?
I punteggi pubblici usano solo le domande a cui hanno risposto tutti i modelli confrontati, così nessun modello si avvantaggia di un insieme di domande più facile. Il round 4 ha 45 domande di questo tipo e 540 valutazioni alla cieca. Il benchmark misura anche il tempo medio fino alla risposta completa.
Risultati

| # | Modello | Fornitore | Complessivo | Accuratezza | Tono | Risposta media |
|---|---|---|---|---|---|---|
| 1 | ChatGPT 5.6 Sol | OpenAI | 71,7 | 55,4 | 86,0 | 3,5 s |
| 2 | ChatGPT 5.6 Luna | OpenAI | 69,8 | 52,7 | 88,0 | 2,8 s |
| 3 | ChatGPT 5.6 Terra | OpenAI | 69,7 | 51,3 | 89,7 | 3,2 s |
| 4 | Grok 4.1 Fast | xAI | 65,2 | 49,0 | 82,1 | 2,2 s |
| 5 | Claude Haiku 4.5 | Anthropic | 65,1 | 45,7 | 85,4 | 4,0 s |
| 6 | ChatGPT 4.1 mini | OpenAI | 63,9 | 41,6 | 85,2 | 2,9 s |
| 7 | Claude Sonnet 5 | Anthropic | 63,6 | 40,3 | 85,9 | 7,8 s |
| 8 | Gemini 3.7 Flash | 63,6 | 35,4 | 89,3 | 10,1 s | |
| 9 | Grok 4.6 | xAI | 63,0 | 41,0 | 81,1 | 49,7 s |
| 10 | Claude Opus 5 | Anthropic | 61,2 | 37,4 | 87,8 | 11,4 s |
| 11 | ChatGPT 4.1 | OpenAI | 61,2 | 34,4 | 85,3 | 2,3 s |
| 12 | Gemini 3.5 Flash-Lite | 56,8 | 32,8 | 81,3 | 1,3 s |
Punteggi 0–100, più alto è meglio; per il tempo di risposta, più basso è meglio. Il CSV in «Scarica i dati» contiene tutti e sei i criteri per ogni modello. Fonte: Chaterimo CX-LLM Benchmark, round 4, 30 agosto 2026.
Quali modelli sono in testa?
I tre modelli ChatGPT 5.6 occupano i primi tre posti con 69,7–71,7 punti. Seguono Grok 4.1 Fast con 65,2 e Claude Haiku 4.5 con 65,1. L'ultimo modello, Gemini 3.5 Flash-Lite, è 14,9 punti dietro il primo, quindi in questo round la scelta del modello ha fatto una differenza netta.
Quali di questi modelli puoi usare oggi?
I fornitori sostituiscono le versioni dei modelli ogni pochi mesi. Il 19 ottobre 2026, quattro dei dodici modelli del round 4 sono selezionabili in Chaterimo: Grok 4.1 Fast (65,2), ChatGPT 4.1 mini (63,9), ChatGPT 4.1 (61,2) e Gemini 3.5 Flash-Lite (56,8). Gli altri sono stati sostituiti da versioni più recenti, che non facevano parte del round 4.
ChatGPT 4.1 mini è il modello più stabile del benchmark. Ha partecipato a tutti e quattro i round e ogni volta ha ottenuto tra 60,8 e 63,9 punti.
Perché l'accuratezza ha il punteggio più basso?
L'accuratezza controlla se i fatti di una risposta sono corretti: prodotti, prezzi, disponibilità, consegna e condizioni di reso. Anche con lo stesso contesto dalla base di conoscenza, il modello migliore ha raggiunto 55,4 punti e il più debole 32,8. Il tono, invece, ha ottenuto tra 81 e 90 punti per ogni modello.

Per un negozio questo significa che una risposta scorrevole e cordiale non prova che sia corretta. Controlla i fatti nelle risposte del tuo chatbot prima di fidarti e mantieni completi il catalogo e le condizioni da cui attinge.
Quanto velocemente rispondono i modelli?
Gemini 3.5 Flash-Lite ha risposto in media in 1,3 s e Grok 4.1 Fast in 2,2 s. Grok 4.6 ha impiegato 49,7 s, Claude Opus 5 11,4 s e Gemini 3.7 Flash 10,1 s. Un cliente che aspetta nella finestra della chat nota ogni secondo, quindi la velocità conta nella decisione quanto il punteggio.
Come si confrontano i quattro round?
Ogni round usa un insieme diverso di domande, quindi i risultati tra un round e l'altro mostrano una tendenza, non un confronto controllato. Claude Haiku 4.5 ha ottenuto 64,3, 49,1, 53,5 e 65,1 nei round da 1 a 4; oscillazioni del genere dipendono soprattutto dall'insieme di domande. Confronta i modelli all'interno di un round.
Limiti
- Il giudice è un modello IA, non una persona. I suoi punteggi seguono i criteri descritti sopra, ma può avere punti ciechi.
- Nel round 4 un solo modello giudice di Google ha valutato tutte le risposte, e anche due dei modelli testati sono di Google. Il prossimo round usa giudici di OpenAI, Anthropic, Google e xAI.
- 45 domande sono un piccolo campione di ciò che chiedono i clienti.
- I risultati valgono per le versioni dei modelli e la data del round 4. Versioni più recenti possono ottenere punteggi diversi.
- Le domande vengono da negozi che usano Chaterimo; in altri settori la classifica dei modelli può essere diversa.
Modelli testati
- ChatGPT 5.6 Sol
- ChatGPT 5.6 Luna
- ChatGPT 5.6 Terra
- ChatGPT 4.1 mini
gpt-4.1-mini - ChatGPT 4.1
gpt-4.1 - Claude Sonnet 5
- Claude Opus 5
- Claude Haiku 4.5
- Gemini 3.7 Flash
- Gemini 3.5 Flash-Lite
gemini-3.5-flash-lite - Grok 4.1 Fast
grok-4-1-fast-non-reasoning - Grok 4.6
Scarica i dati
Come citare
Chaterimo (2026). Migliore IA per l'assistenza clienti: 12 modelli alla cieca. Chaterimo CX-LLM Benchmark, 2026 Q3. https://www.chaterimo.com/it/blog/migliore-ia-per-assistenza-clienti/
Domande frequenti
Qual è la migliore IA per l'assistenza clienti nell'e-commerce?
Nel round 4 del Chaterimo CX-LLM Benchmark (30 agosto 2026), ChatGPT 5.6 Sol ha ottenuto il punteggio più alto, 71,7 su 100. Tra i modelli selezionabili in Chaterimo il 19 ottobre 2026, il migliore è stato Grok 4.1 Fast con 65,2.
Per l'assistenza clienti è meglio ChatGPT o Claude?
Nel round 4 i modelli ChatGPT 5.6 hanno ottenuto 69,7–71,7 punti, i modelli Claude 61,2–65,1. La differenza viene soprattutto dall'accuratezza; nel tono tutti i modelli hanno ottenuto punteggi simili.
Come vengono assegnati i punteggi del benchmark?
Un modello giudice valuta ogni risposta anonima da 0 a 100 su accuratezza, rilevanza, completezza, utilità, tono e concisione. Nel round 4 il giudice era Gemini 3.1 Pro di Google, che non è uno dei modelli testati.
Ricerca · Assistenza clienti con IA
Lo stato dell'assistenza clienti con IA nell'e-commerce 2026
1,09 milioni di messaggi da un massimo di 95 negozi online, febbraio – maggio 2026. Quanto gestisce l'IA, quando scrivono i clienti e quali modelli usano.
Articolo · Modelli LLM
Come scegliere un LLM per l'assistenza clienti
Accuratezza sui tuoi dati, velocità, costo e tono. Come confrontare ChatGPT, Claude, Gemini e Grok per un negozio online e testarli sulle tue domande.
Guida · Chiave API OpenAI
Come ottenere una chiave API OpenAI per Chaterimo
Crea un account sulla OpenAI Platform, aggiungi crediti prepagati, crea una chiave API segreta e collegala a Chaterimo come chiave API propria (BYOK).
Modifiche
- Edizione 2026 Q3 del Chaterimo CX-LLM Benchmark: round 4 (30 agosto 2026), 12 modelli, 45 domande, 540 valutazioni alla cieca. Aggiunti metodologia, limiti e dati da scaricare.
- Pubblicato (prima edizione: 2.535 valutazioni alla cieca di 18 modelli in tre round).