Serie Chaterimo CX-LLM Benchmark · edición 2026 Q3
Investigación · Modelos LLM
Mejor IA para atención al cliente: 12 LLM evaluados a ciegas
ChatGPT, Claude, Gemini y Grok ante 45 preguntas reales de atención al cliente en e-commerce, evaluados a ciegas por un modelo juez de IA. Edición 2026 Q3.
Conclusiones clave
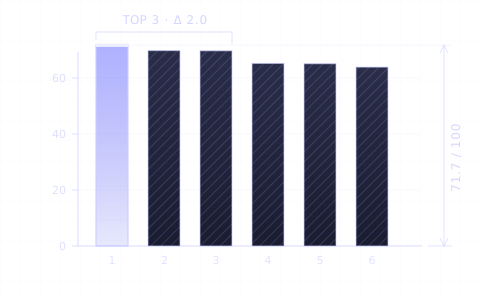
- 01En la ronda 4 (30 de agosto de 2026), los tres modelos ChatGPT 5.6 encabezan la clasificación con 71,7, 69,8 y 69,7 puntos sobre 100.
- 02De los modelos que se pueden seleccionar en Chaterimo el 19 de octubre de 2026, Grok 4.1 Fast obtuvo la mejor puntuación (65,2) y respondió en 2,2 s de media.
- 03La precisión es el criterio más débil de todos los modelos: el mejor alcanzó 55,4, mientras que en tono los doce obtuvieron entre 81 y 90.
- 04Los tiempos medios de respuesta van de 1,3 s (Gemini 3.5 Flash-Lite) a 49,7 s (Grok 4.6).
- Periodo de los datos
- Round 4, snapshot of 30 August 2026
Contenido 11
¿Qué modelo de lenguaje responde mejor a los clientes de una tienda online? En la ronda 4 del Chaterimo CX-LLM Benchmark, 12 modelos respondieron a las mismas 45 preguntas reales de atención al cliente, y un modelo juez de IA evaluó sus respuestas a ciegas. Los tres modelos ChatGPT 5.6 encabezaron la clasificación con entre 69,7 y 71,7 puntos sobre 100. Todos los modelos obtuvieron su puntuación más baja en precisión, la proporción de datos que acertaron.
Metodología
Las preguntas proceden de conversaciones reales de atención al cliente en tiendas online que usan Chaterimo. Cada modelo recibe las mismas instrucciones del sistema (system prompt), el mismo contexto de la base de conocimiento y la misma pregunta. Sus respuestas se etiquetan de forma anónima (Respuesta A, Respuesta B…) y las puntúa un modelo juez. En la ronda 4, el juez fue Gemini 3.1 Pro (preview) de Google, que no es uno de los 12 modelos evaluados, así que ningún modelo puntuó su propia respuesta. En la ronda 1 hubo jueces de OpenAI, Anthropic, Google y xAI; en las rondas 2 y 3, jueces de OpenAI y Google.
Cada respuesta recibe una puntuación de 0 a 100 en seis criterios. La puntuación global es su media ponderada:
- Precisión (30 %)
- ¿Son correctos los datos sobre productos, precios y políticas?
- Relevancia (20 %)
- ¿Responde a lo que preguntó el cliente?
- Completitud (15 %)
- ¿Contiene todo lo que el cliente necesita para decidir?
- Utilidad (15 %)
- ¿Acerca al cliente a una compra o a una solución?
- Tono (10 %)
- ¿Es amable y profesional?
- Concisión (10 %)
- ¿Es breve sin omitir nada importante?
Las puntuaciones públicas solo usan las preguntas que respondieron todos los modelos comparados, así que ningún modelo se beneficia de una combinación de preguntas más fácil. La ronda 4 tiene 45 de estas preguntas y 540 evaluaciones a ciegas. El benchmark también mide el tiempo medio hasta una respuesta completa.
Resultados

| # | Modelo | Proveedor | Global | Precisión | Tono | Respuesta media |
|---|---|---|---|---|---|---|
| 1 | ChatGPT 5.6 Sol | OpenAI | 71,7 | 55,4 | 86,0 | 3,5 s |
| 2 | ChatGPT 5.6 Luna | OpenAI | 69,8 | 52,7 | 88,0 | 2,8 s |
| 3 | ChatGPT 5.6 Terra | OpenAI | 69,7 | 51,3 | 89,7 | 3,2 s |
| 4 | Grok 4.1 Fast | xAI | 65,2 | 49,0 | 82,1 | 2,2 s |
| 5 | Claude Haiku 4.5 | Anthropic | 65,1 | 45,7 | 85,4 | 4,0 s |
| 6 | ChatGPT 4.1 mini | OpenAI | 63,9 | 41,6 | 85,2 | 2,9 s |
| 7 | Claude Sonnet 5 | Anthropic | 63,6 | 40,3 | 85,9 | 7,8 s |
| 8 | Gemini 3.7 Flash | 63,6 | 35,4 | 89,3 | 10,1 s | |
| 9 | Grok 4.6 | xAI | 63,0 | 41,0 | 81,1 | 49,7 s |
| 10 | Claude Opus 5 | Anthropic | 61,2 | 37,4 | 87,8 | 11,4 s |
| 11 | ChatGPT 4.1 | OpenAI | 61,2 | 34,4 | 85,3 | 2,3 s |
| 12 | Gemini 3.5 Flash-Lite | 56,8 | 32,8 | 81,3 | 1,3 s |
Puntuaciones de 0 a 100: cuanto más alta, mejor; en el tiempo de respuesta, cuanto más bajo, mejor. El CSV de «Descargar los datos» contiene los seis criterios de todos los modelos. Fuente: Chaterimo CX-LLM Benchmark, ronda 4, 30 de agosto de 2026.
¿Qué modelos lideran?
Los tres modelos ChatGPT 5.6 ocupan los tres primeros puestos, con entre 69,7 y 71,7 puntos. Les siguen Grok 4.1 Fast con 65,2 y Claude Haiku 4.5 con 65,1. El último modelo, Gemini 3.5 Flash-Lite, queda 14,9 puntos por detrás del primero, así que en esta ronda la elección del modelo marcó una diferencia clara.
¿Cuáles de estos modelos puede usar hoy?
Los proveedores sustituyen las versiones de sus modelos cada pocos meses. A 19 de octubre de 2026, cuatro de los doce modelos de la ronda 4 se pueden seleccionar en Chaterimo: Grok 4.1 Fast (65,2), ChatGPT 4.1 mini (63,9), ChatGPT 4.1 (61,2) y Gemini 3.5 Flash-Lite (56,8). Los demás se han sustituido por versiones más nuevas, que no formaron parte de la ronda 4.
ChatGPT 4.1 mini es el modelo más estable del benchmark. Participó en las cuatro rondas y obtuvo cada vez entre 60,8 y 63,9 puntos.
¿Por qué la precisión es la puntuación más baja?
La precisión comprueba si los datos de una respuesta son correctos: productos, precios, stock y políticas de envío y devolución. Incluso con el mismo contexto de la base de conocimiento, el mejor modelo alcanzó 55,4 puntos y el más débil, 32,8. En tono, en cambio, todos los modelos obtuvieron entre 81 y 90.

Para una tienda, esto significa que una respuesta fluida y amable no demuestra que sea correcta. Compruebe los datos de las respuestas de su chatbot antes de confiar en él, y mantenga completos el catálogo y las políticas que lee.
¿Con qué rapidez responden los modelos?
Gemini 3.5 Flash-Lite respondió en 1,3 s de media y Grok 4.1 Fast, en 2,2 s. Grok 4.6 necesitó 49,7 s; Claude Opus 5, 11,4 s, y Gemini 3.7 Flash, 10,1 s. Un cliente que espera en una ventana de chat nota cada segundo, así que la velocidad cuenta en la decisión tanto como la puntuación.
¿Cómo se comparan las cuatro rondas?
Cada ronda usa un conjunto de preguntas distinto, así que los resultados entre rondas muestran una tendencia, no una comparación controlada. Claude Haiku 4.5 obtuvo 64,3, 49,1, 53,5 y 65,1 puntos en las rondas 1 a 4; estas oscilaciones se deben sobre todo a la combinación de preguntas. Compare los modelos dentro de una misma ronda.
Limitaciones
- El juez es un modelo de IA, no una persona. Sus puntuaciones siguen los criterios anteriores, pero puede tener puntos ciegos.
- En la ronda 4, un único modelo juez de Google puntuó todas las respuestas, y dos de los modelos evaluados también son de Google. La próxima ronda usa jueces de OpenAI, Anthropic, Google y xAI.
- 45 preguntas son una muestra pequeña de lo que preguntan los clientes.
- Los resultados valen para las versiones de los modelos y la fecha de la ronda 4. Las versiones más nuevas pueden obtener otras puntuaciones.
- Las preguntas proceden de tiendas que usan Chaterimo; en otros sectores, el orden de los modelos puede ser distinto.
Modelos evaluados
- ChatGPT 5.6 Sol
- ChatGPT 5.6 Luna
- ChatGPT 5.6 Terra
- ChatGPT 4.1 mini
gpt-4.1-mini - ChatGPT 4.1
gpt-4.1 - Claude Sonnet 5
- Claude Opus 5
- Claude Haiku 4.5
- Gemini 3.7 Flash
- Gemini 3.5 Flash-Lite
gemini-3.5-flash-lite - Grok 4.1 Fast
grok-4-1-fast-non-reasoning - Grok 4.6
Descargar los datos
Cómo citar
Chaterimo (2026). Mejor IA para atención al cliente: 12 LLM evaluados a ciegas. Chaterimo CX-LLM Benchmark, 2026 Q3. https://www.chaterimo.com/es/blog/mejor-ia-para-atencion-al-cliente/
Preguntas frecuentes
¿Qué IA es la mejor para la atención al cliente en e-commerce?
En la ronda 4 del Chaterimo CX-LLM Benchmark (30 de agosto de 2026), ChatGPT 5.6 Sol obtuvo la puntuación más alta, con 71,7 sobre 100. De los modelos que se podían seleccionar en Chaterimo el 19 de octubre de 2026, Grok 4.1 Fast obtuvo la mejor puntuación, con 65,2.
¿Es mejor ChatGPT o Claude para la atención al cliente?
En la ronda 4, los modelos ChatGPT 5.6 obtuvieron entre 69,7 y 71,7 puntos, y los modelos Claude, entre 61,2 y 65,1. La diferencia viene sobre todo de la precisión; en tono, todos los modelos puntuaron de forma parecida.
¿Cómo se puntúa el benchmark?
Un modelo juez puntúa cada respuesta anónima de 0 a 100 en precisión, relevancia, completitud, utilidad, tono y concisión. En la ronda 4, el juez fue Gemini 3.1 Pro de Google, que no es uno de los modelos evaluados.
Investigación · Atención al cliente
Estado de la atención al cliente con IA en e-commerce 2026
1,09 millones de mensajes de clientes de hasta 95 tiendas online, de febrero a mayo de 2026. Cuánto atiende la IA, cuándo preguntan y qué modelos se usan.
Artículo · Modelos LLM
Cómo elegir un LLM para la atención al cliente
Precisión con sus datos, velocidad, costo y tono. Cómo comparar ChatGPT, Claude, Gemini y Grok para una tienda online y probarlos con sus preguntas.
Guía · Clave API de OpenAI
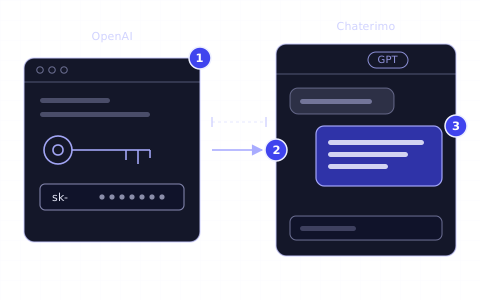
Cómo obtener una clave API de OpenAI para Chaterimo
Cree una cuenta en OpenAI Platform, añada créditos prepago, cree una clave API secreta y conéctela a Chaterimo como clave API propia (BYOK).
Historial de cambios
- Edición 2026 Q3 del Chaterimo CX-LLM Benchmark: ronda 4 (30 de agosto de 2026), 12 modelos, 45 preguntas, 540 evaluaciones a ciegas. Se añadieron la metodología, las limitaciones y la descarga de datos.
- Publicado (primera edición: 2535 evaluaciones a ciegas de 18 modelos en tres rondas).