Série Chaterimo CX-LLM Benchmark · edição 2026 Q3
Pesquisa · Modelos LLM
Melhor IA para atendimento ao cliente: 12 LLMs em teste cego
ChatGPT, Claude, Gemini e Grok em 45 perguntas reais de atendimento de lojas virtuais, avaliados às cegas por um modelo juiz de IA. Edição 2026 Q3.
Principais conclusões
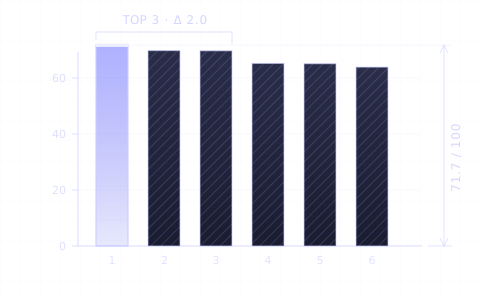
- 01Na rodada 4 (30 de agosto de 2026), os três modelos ChatGPT 5.6 lideram com 71,7, 69,8 e 69,7 pontos de 100.
- 02Dos modelos que podem ser selecionados no Chaterimo em 19 de outubro de 2026, o Grok 4.1 Fast teve a melhor pontuação (65,2) e respondeu em 2,2 s em média.
- 03A precisão é o critério mais fraco de todos os modelos: o melhor chegou a 55,4, enquanto o tom ficou entre 81 e 90 nos doze.
- 04Os tempos médios de resposta vão de 1,3 s (Gemini 3.5 Flash-Lite) a 49,7 s (Grok 4.6).
- Período dos dados
- Round 4, snapshot of 30 August 2026
Conteúdo 11
Qual modelo de linguagem responde melhor aos clientes de lojas virtuais? Na rodada 4 do Chaterimo CX-LLM Benchmark, 12 modelos responderam às mesmas 45 perguntas reais de atendimento ao cliente e foram avaliados às cegas por um modelo juiz de IA. Os três modelos ChatGPT 5.6 lideraram com 69,7 a 71,7 pontos de 100. Todos os modelos tiveram a nota mais baixa em precisão, a parcela de fatos que eles acertaram.
Metodologia
As perguntas vêm de conversas reais de atendimento ao cliente em lojas virtuais que usam o Chaterimo. Cada modelo recebe o mesmo prompt de sistema, o mesmo contexto da base de conhecimento e a mesma pergunta. As respostas são identificadas de forma anônima (Resposta A, Resposta B …) e pontuadas por um modelo juiz. Na rodada 4, o juiz foi o Gemini 3.1 Pro (preview), do Google, que não está entre os 12 modelos testados, então nenhum modelo avaliou a própria resposta. A rodada 1 usou juízes da OpenAI, da Anthropic, do Google e da xAI; as rodadas 2 e 3, juízes da OpenAI e do Google.
Cada resposta recebe uma pontuação de 0 a 100 em seis critérios. A pontuação geral é a média ponderada deles:
- Precisão (30%)
- Os fatos sobre produtos, preços e políticas estão corretos?
- Relevância (20%)
- A resposta trata do que o cliente perguntou?
- Completude (15%)
- Ela contém tudo de que o cliente precisa para decidir?
- Utilidade (15%)
- Ela leva o cliente a uma compra ou a uma solução?
- Tom (10%)
- Ela é cordial e profissional?
- Concisão (10%)
- Ela é curta sem deixar de fora nada importante?
As pontuações públicas usam só as perguntas que todos os modelos comparados responderam, então nenhum modelo se beneficia de uma combinação mais fácil. A rodada 4 tem 45 dessas perguntas e 540 avaliações às cegas. O benchmark também mede o tempo médio até uma resposta completa.
Resultados

| # | Modelo | Provedor | Geral | Precisão | Tom | Tempo médio de resposta |
|---|---|---|---|---|---|---|
| 1 | ChatGPT 5.6 Sol | OpenAI | 71,7 | 55,4 | 86,0 | 3,5 s |
| 2 | ChatGPT 5.6 Luna | OpenAI | 69,8 | 52,7 | 88,0 | 2,8 s |
| 3 | ChatGPT 5.6 Terra | OpenAI | 69,7 | 51,3 | 89,7 | 3,2 s |
| 4 | Grok 4.1 Fast | xAI | 65,2 | 49,0 | 82,1 | 2,2 s |
| 5 | Claude Haiku 4.5 | Anthropic | 65,1 | 45,7 | 85,4 | 4,0 s |
| 6 | ChatGPT 4.1 mini | OpenAI | 63,9 | 41,6 | 85,2 | 2,9 s |
| 7 | Claude Sonnet 5 | Anthropic | 63,6 | 40,3 | 85,9 | 7,8 s |
| 8 | Gemini 3.7 Flash | 63,6 | 35,4 | 89,3 | 10,1 s | |
| 9 | Grok 4.6 | xAI | 63,0 | 41,0 | 81,1 | 49,7 s |
| 10 | Claude Opus 5 | Anthropic | 61,2 | 37,4 | 87,8 | 11,4 s |
| 11 | ChatGPT 4.1 | OpenAI | 61,2 | 34,4 | 85,3 | 2,3 s |
| 12 | Gemini 3.5 Flash-Lite | 56,8 | 32,8 | 81,3 | 1,3 s |
Pontuações de 0 a 100, quanto maior, melhor; no tempo de resposta, quanto menor, melhor. O CSV em “Baixar os dados” tem os seis critérios de todos os modelos. Fonte: Chaterimo CX-LLM Benchmark, rodada 4, 30 de agosto de 2026.
Quais modelos lideram?
Os três modelos ChatGPT 5.6 ocupam os três primeiros lugares, com 69,7 a 71,7 pontos. Em seguida vêm o Grok 4.1 Fast, com 65,2, e o Claude Haiku 4.5, com 65,1. O último modelo, o Gemini 3.5 Flash-Lite, ficou 14,9 pontos atrás do primeiro, então nesta rodada a escolha do modelo fez uma diferença clara.
Quais desses modelos você pode usar hoje?
Os provedores substituem as versões dos modelos a cada poucos meses. Em 19 de outubro de 2026, quatro dos doze modelos da rodada 4 podem ser selecionados no Chaterimo: Grok 4.1 Fast (65,2), ChatGPT 4.1 mini (63,9), ChatGPT 4.1 (61,2) e Gemini 3.5 Flash-Lite (56,8). Os outros foram substituídos por versões mais novas, que não fizeram parte da rodada 4.
O ChatGPT 4.1 mini é o modelo mais estável do benchmark. Ele participou das quatro rodadas e marcou entre 60,8 e 63,9 em todas.
Por que a precisão tem a nota mais baixa?
A precisão verifica se os fatos de uma resposta estão corretos: produtos, preços, estoque, regras de entrega e de devolução. Mesmo com o mesmo contexto da base de conhecimento, o melhor modelo chegou a 55,4 pontos e o mais fraco a 32,8. O tom, ao contrário, ficou entre 81 e 90 em todos os modelos.

Para uma loja, isso significa que uma resposta fluente e cordial não prova que ela esteja correta. Confira os fatos nas respostas do seu chatbot antes de confiar nele e mantenha completos o catálogo e as políticas que ele lê.
Com que rapidez os modelos respondem?
O Gemini 3.5 Flash-Lite respondeu em 1,3 s em média, e o Grok 4.1 Fast em 2,2 s. O Grok 4.6 precisou de 49,7 s, o Claude Opus 5 de 11,4 s e o Gemini 3.7 Flash de 10,1 s. Um cliente que espera na janela de chat percebe cada segundo, então a velocidade pesa na decisão tanto quanto a pontuação.
Como as quatro rodadas se comparam?
Cada rodada usa um conjunto diferente de perguntas, então os resultados entre rodadas mostram uma tendência, não uma comparação controlada. O Claude Haiku 4.5 marcou 64,3, 49,1, 53,5 e 65,1 nas rodadas 1 a 4; essas oscilações vêm principalmente da combinação de perguntas. Compare os modelos dentro de uma mesma rodada.
Limitações
- O juiz é um modelo de IA, não uma pessoa. As notas dele seguem os critérios acima, mas ele pode ter pontos cegos.
- Na rodada 4, um único modelo juiz do Google avaliou todas as respostas, e dois dos modelos testados também são do Google. A próxima rodada usa juízes da OpenAI, da Anthropic, do Google e da xAI.
- 45 perguntas são uma amostra pequena do que os clientes perguntam.
- Os resultados valem para as versões dos modelos e para a data da rodada 4. Versões mais novas podem ter outra pontuação.
- As perguntas vêm de lojas que usam o Chaterimo; outros setores podem classificar os modelos de outra forma.
Modelos testados
- ChatGPT 5.6 Sol
- ChatGPT 5.6 Luna
- ChatGPT 5.6 Terra
- ChatGPT 4.1 mini
gpt-4.1-mini - ChatGPT 4.1
gpt-4.1 - Claude Sonnet 5
- Claude Opus 5
- Claude Haiku 4.5
- Gemini 3.7 Flash
- Gemini 3.5 Flash-Lite
gemini-3.5-flash-lite - Grok 4.1 Fast
grok-4-1-fast-non-reasoning - Grok 4.6
Baixar os dados
Como citar
Chaterimo (2026). Melhor IA para atendimento ao cliente: 12 LLMs em teste cego. Chaterimo CX-LLM Benchmark, 2026 Q3. https://www.chaterimo.com/pt-br/blog/melhor-ia-para-atendimento-ao-cliente/
Perguntas frequentes
Qual é a melhor IA para atendimento ao cliente no e-commerce?
Na rodada 4 do Chaterimo CX-LLM Benchmark (30 de agosto de 2026), o ChatGPT 5.6 Sol teve a maior pontuação, 71,7 de 100. Dos modelos que podem ser selecionados no Chaterimo em 19 de outubro de 2026, o Grok 4.1 Fast teve a melhor pontuação, 65,2.
O ChatGPT ou o Claude é melhor para atendimento ao cliente?
Na rodada 4, os modelos ChatGPT 5.6 marcaram de 69,7 a 71,7, e os modelos Claude de 61,2 a 65,1. A diferença vem principalmente da precisão; no tom, todos os modelos tiveram notas parecidas.
Como o benchmark é pontuado?
Um modelo juiz dá a cada resposta anônima uma nota de 0 a 100 em precisão, relevância, completude, utilidade, tom e concisão. Na rodada 4, o juiz foi o Gemini 3.1 Pro, do Google, que não é um dos modelos testados.
Pesquisa · Atendimento ao cliente com IA
O estado do atendimento ao cliente com IA no e-commerce 2026
1,09 milhão de mensagens de até 95 lojas virtuais (fevereiro a maio de 2026): quanto a IA atende, quando os clientes escrevem e que modelos as lojas usam.
Artigo · Modelos LLM
Como escolher um LLM para atendimento ao cliente
Precisão com seus dados, velocidade, custo e tom: como comparar ChatGPT, Claude, Gemini e Grok para uma loja virtual e testá-los com as suas perguntas.
Guia · Chave de API do Gemini
Como obter uma chave de API do Gemini para o Chaterimo
Entre no Google AI Studio, crie uma chave de API do Gemini, configure o faturamento do projeto e conecte-a ao Chaterimo como sua chave própria (BYOK).
Histórico de alterações
- Edição 2026 Q3 do Chaterimo CX-LLM Benchmark: rodada 4 (30 de agosto de 2026), 12 modelos, 45 perguntas, 540 avaliações às cegas. Adicionados a metodologia, as limitações e o download dos dados.
- Publicado (primeira edição: 2.535 avaliações às cegas de 18 modelos em três rodadas).