Série Chaterimo CX-LLM Benchmark · edice 2026 Q3
Výzkum · LLM modely
Nejlepší AI pro zákaznickou podporu: 12 modelů naslepo
ChatGPT, Claude, Gemini a Grok na 45 skutečných dotazech ze zákaznické podpory e-shopů, hodnocené naslepo AI modelem. Vydání 2026 Q3.
Klíčová zjištění
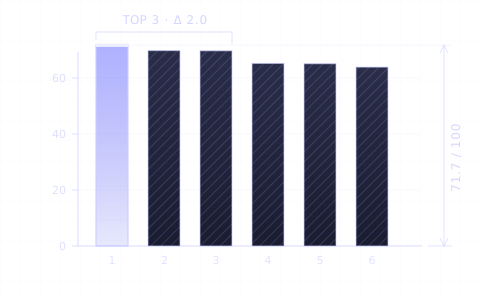
- 01Ve 4. kole (30. srpna 2026) vedou tři modely ChatGPT 5.6 s 71,7, 69,8 a 69,7 bodu ze 100.
- 02Z modelů, které lze v Chaterimu vybrat k 19. říjnu 2026, dosáhl nejlepšího skóre Grok 4.1 Fast (65,2) a odpovídal v průměru za 2,2 s.
- 03Přesnost je nejslabším kritériem každého modelu: nejlepší dosáhl 55,4, zatímco tón získal u všech dvanácti 81 až 90 bodů.
- 04Průměrná doba odezvy se pohybuje od 1,3 s (Gemini 3.5 Flash-Lite) po 49,7 s (Grok 4.6).
- Období dat
- Round 4, snapshot of 30 August 2026
Obsah 11
Který jazykový model odpovídá zákazníkům e-shopů nejlépe? Ve 4. kole série Chaterimo CX-LLM Benchmark odpovědělo 12 modelů na stejných 45 skutečných dotazů ze zákaznické podpory a hodnoticí AI model je naslepo obodoval. Vedly tři modely ChatGPT 5.6 se 69,7 až 71,7 bodu ze 100. Všechny modely měly nejnižší skóre v přesnosti, tedy v podílu fakt, která uvedly správně.
Metodika
Dotazy pocházejí ze skutečných konverzací zákaznické podpory v e-shopech, které používají Chaterimo. Každý model dostane stejný systémový prompt, stejný kontext ze znalostní báze a stejný dotaz. Odpovědi jsou označené anonymně (Odpověď A, Odpověď B …) a boduje je hodnoticí model. Ve 4. kole hodnotil Gemini 3.1 Pro (preview) od Googlu, který nepatří mezi 12 testovaných modelů, takže žádný model nehodnotil vlastní odpověď. V 1. kole hodnotily modely OpenAI, Anthropic, Google a xAI, ve 2. a 3. kole modely OpenAI a Google.
Každá odpověď dostane v šesti kritériích skóre od 0 do 100. Celkové skóre je jejich vážený průměr:
- Přesnost (30 %)
- Jsou fakta o produktech, cenách a obchodních podmínkách správně?
- Relevance (20 %)
- Odpovídá odpověď na to, na co se zákazník ptal?
- Úplnost (15 %)
- Obsahuje vše, co zákazník potřebuje k rozhodnutí?
- Užitečnost (15 %)
- Posouvá zákazníka k nákupu nebo k vyřešení problému?
- Tón (10 %)
- Je přátelská a profesionální?
- Stručnost (10 %)
- Je krátká a přitom nevynechává nic důležitého?
Zveřejněná skóre počítají jen s dotazy, na které odpověděly všechny porovnávané modely, takže žádný model nezvýhodní snazší skladba dotazů. Ve 4. kole je takových dotazů 45 a slepých hodnocení 540. Benchmark měří také průměrnou dobu do úplné odpovědi.
Výsledky

| # | Model | Poskytovatel | Celkem | Přesnost | Tón | Prům. odezva |
|---|---|---|---|---|---|---|
| 1 | ChatGPT 5.6 Sol | OpenAI | 71,7 | 55,4 | 86,0 | 3,5 s |
| 2 | ChatGPT 5.6 Luna | OpenAI | 69,8 | 52,7 | 88,0 | 2,8 s |
| 3 | ChatGPT 5.6 Terra | OpenAI | 69,7 | 51,3 | 89,7 | 3,2 s |
| 4 | Grok 4.1 Fast | xAI | 65,2 | 49,0 | 82,1 | 2,2 s |
| 5 | Claude Haiku 4.5 | Anthropic | 65,1 | 45,7 | 85,4 | 4,0 s |
| 6 | ChatGPT 4.1 mini | OpenAI | 63,9 | 41,6 | 85,2 | 2,9 s |
| 7 | Claude Sonnet 5 | Anthropic | 63,6 | 40,3 | 85,9 | 7,8 s |
| 8 | Gemini 3.7 Flash | 63,6 | 35,4 | 89,3 | 10,1 s | |
| 9 | Grok 4.6 | xAI | 63,0 | 41,0 | 81,1 | 49,7 s |
| 10 | Claude Opus 5 | Anthropic | 61,2 | 37,4 | 87,8 | 11,4 s |
| 11 | ChatGPT 4.1 | OpenAI | 61,2 | 34,4 | 85,3 | 2,3 s |
| 12 | Gemini 3.5 Flash-Lite | 56,8 | 32,8 | 81,3 | 1,3 s |
Skóre 0–100, vyšší je lepší; u doby odezvy je lepší nižší. CSV v části „Data ke stažení“ obsahuje všech šest kritérií pro každý model. Zdroj: Chaterimo CX-LLM Benchmark, 4. kolo, 30. srpna 2026.
Které modely vedou?
Tři modely ChatGPT 5.6 obsadily první tři místa s 69,7 až 71,7 bodu. Následuje Grok 4.1 Fast s 65,2 a Claude Haiku 4.5 s 65,1. Poslední model, Gemini 3.5 Flash-Lite, ztrácí na první místo 14,9 bodu, takže v tomto kole na volbě modelu zřetelně záleželo.
Které z těchto modelů můžete používat dnes?
Poskytovatelé nahrazují verze modelů každých pár měsíců. K 19. říjnu 2026 lze v Chaterimu vybrat čtyři z dvanácti modelů 4. kola: Grok 4.1 Fast (65,2), ChatGPT 4.1 mini (63,9), ChatGPT 4.1 (61,2) a Gemini 3.5 Flash-Lite (56,8). Ostatní nahradily novější verze, které se 4. kola neúčastnily.
ChatGPT 4.1 mini je nejstabilnější model benchmarku. Zúčastnil se všech čtyř kol a pokaždé získal 60,8 až 63,9 bodu.
Proč má přesnost nejnižší skóre?
Přesnost kontroluje, jestli jsou fakta v odpovědi správně: produkty, ceny, skladovost, doručení a podmínky vrácení zboží. I se stejným kontextem ze znalostní báze dosáhl nejlepší model 55,4 bodu a nejslabší 32,8. Tón naopak získal u všech modelů 81 až 90 bodů.

Pro e-shop to znamená, že plynulá a přátelská odpověď ještě nedokazuje, že je správná. Než chatbotovi začnete věřit, zkontrolujte fakta v jeho odpovědích a udržujte úplný katalog a obchodní podmínky, ze kterých čerpá.
Jak rychle modely odpovídají?
Gemini 3.5 Flash-Lite odpovídal v průměru za 1,3 s a Grok 4.1 Fast za 2,2 s. Nejdéle trvaly odpovědi modelům Grok 4.6 (49,7 s), Claude Opus 5 (11,4 s) a Gemini 3.7 Flash (10,1 s). Zákazník, který čeká v chatovacím okně, vnímá každou sekundu, takže rychlost patří do rozhodování stejně jako skóre.
Jak porovnat výsledky čtyř kol?
Každé kolo používá jinou sadu dotazů, takže výsledky napříč koly ukazují trend, ne kontrolované srovnání. Claude Haiku 4.5 získal v 1. až 4. kole 64,3, 49,1, 53,5 a 65,1 bodu; takové výkyvy způsobuje hlavně skladba dotazů. Modely porovnávejte v rámci jednoho kola.
Omezení
- Hodnotitelem je AI model, ne člověk. Jeho skóre se řídí výše uvedenými kritérii, ale může mít slepá místa.
- Ve 4. kole hodnotil všechny odpovědi jediný hodnoticí model od Googlu a dva z testovaných modelů jsou také od Googlu. Příští kolo použije hodnoticí modely OpenAI, Anthropic, Google a xAI.
- Vzorek 45 dotazů je jen malá část toho, na co se zákazníci ptají.
- Výsledky platí pro verze modelů a datum 4. kola. Novější verze mohou dosáhnout jiného skóre.
- Dotazy pocházejí z e-shopů, které používají Chaterimo; v jiných oborech mohou modely skončit v jiném pořadí.
Testované modely
- ChatGPT 5.6 Sol
- ChatGPT 5.6 Luna
- ChatGPT 5.6 Terra
- ChatGPT 4.1 mini
gpt-4.1-mini - ChatGPT 4.1
gpt-4.1 - Claude Sonnet 5
- Claude Opus 5
- Claude Haiku 4.5
- Gemini 3.7 Flash
- Gemini 3.5 Flash-Lite
gemini-3.5-flash-lite - Grok 4.1 Fast
grok-4-1-fast-non-reasoning - Grok 4.6
Data ke stažení
Jak citovat
Chaterimo (2026). Nejlepší AI pro zákaznickou podporu: 12 modelů naslepo. Chaterimo CX-LLM Benchmark, 2026 Q3. https://www.chaterimo.com/cs/blog/nejlepsi-ai-pro-zakaznickou-podporu/
Časté dotazy
Která AI je nejlepší pro zákaznickou podporu e-shopu?
Ve 4. kole série Chaterimo CX-LLM Benchmark (30. srpna 2026) získal nejvyšší skóre ChatGPT 5.6 Sol, 71,7 bodu ze 100. Z modelů, které lze v Chaterimu vybrat k 19. říjnu 2026, dopadl nejlépe Grok 4.1 Fast s 65,2 bodu.
Je pro zákaznickou podporu lepší ChatGPT, nebo Claude?
Ve 4. kole získaly modely ChatGPT 5.6 69,7 až 71,7 bodu, modely Claude 61,2 až 65,1. Rozdíl dělá hlavně přesnost; v tónu dopadly všechny modely podobně.
Jak se benchmark hodnotí?
Hodnoticí model dá každé anonymní odpovědi 0 až 100 bodů za přesnost, relevanci, úplnost, užitečnost, tón a stručnost. Ve 4. kole hodnotil Gemini 3.1 Pro od Googlu, který nepatří mezi testované modely.
Výzkum · AI zákaznická podpora
Stav AI zákaznické podpory v e-commerce 2026
1,09 milionu zpráv zákazníků z až 95 e-shopů, únor až květen 2026. Kolik zvládne AI, kdy se zákazníci ptají a jaké modely e-shopy používají.
Článek · LLM modely
Jak vybrat AI model (LLM) pro zákaznickou podporu
Přesnost na vašich datech, rychlost, cena a tón. Jak porovnat ChatGPT, Claude, Gemini a Grok pro e-shop a otestovat je na vlastních dotazech.
Návod · API klíč Gemini
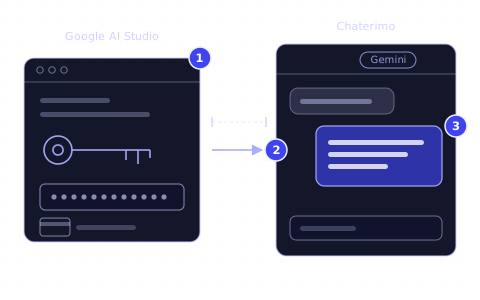
Jak získat API klíč Gemini pro Chaterimo
Přihlaste se do Google AI Studio, vytvořte API klíč Gemini, nastavte fakturaci jeho projektu a vložte klíč do Chaterima jako vlastní klíč (BYOK).
Seznam změn
- Vydání 2026 Q3 série Chaterimo CX-LLM Benchmark: 4. kolo (30. srpna 2026), 12 modelů, 45 dotazů, 540 slepých hodnocení. Doplněna metodika, omezení a data ke stažení.
- Zveřejněno (první vydání: 2 535 slepých hodnocení 18 modelů ve třech kolech).