Seria Chaterimo CX-LLM Benchmark · ediția 2026 Q3
Cercetare · Modele LLM
Cea mai bună AI pentru asistența clienți: 12 modele testate
ChatGPT, Claude, Gemini și Grok pe 45 de întrebări reale de asistență clienți din magazine online, evaluate orb de un model AI judecător. Ediția 2026 Q3.
Concluzii cheie
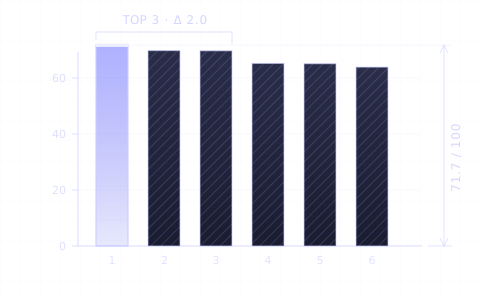
- 01În runda 4 (30 august 2026), cele trei modele ChatGPT 5.6 conduc cu 71,7; 69,8 și 69,7 puncte din 100.
- 02Dintre modelele care pot fi selectate în Chaterimo la 19 octombrie 2026, Grok 4.1 Fast a obținut cel mai bun scor (65,2) și a răspuns în medie în 2,2 s.
- 03Acuratețea este cel mai slab criteriu pentru fiecare model: cel mai bun a atins 55,4, în timp ce la ton toate cele douăsprezece modele au obținut între 81 și 90.
- 04Timpii medii de răspuns variază de la 1,3 s (Gemini 3.5 Flash-Lite) la 49,7 s (Grok 4.6).
- Perioada datelor
- Round 4, snapshot of 30 August 2026
Cuprins 11
Ce model de limbaj le răspunde cel mai bine clienților din comerțul electronic? În runda 4 a Chaterimo CX-LLM Benchmark, 12 modele au răspuns la aceleași 45 de întrebări reale de asistență clienți și au fost evaluate orb de un model AI judecător. Cele trei modele ChatGPT 5.6 au condus cu 69,7–71,7 puncte din 100. Fiecare model a obținut cel mai mic scor la acuratețe, adică ponderea faptelor corecte.
Metodologie
Întrebările provin din conversații reale de asistență clienți din magazine online care folosesc Chaterimo. Fiecare model primește același prompt de sistem, același context din baza de cunoștințe și aceeași întrebare. Răspunsurile sunt etichetate anonim (Răspunsul A, Răspunsul B …) și evaluate de un model judecător. În runda 4, judecătorul a fost Gemini 3.1 Pro (preview) de la Google, care nu se numără printre cele 12 modele testate, așa că niciun model nu și-a evaluat propriul răspuns. Runda 1 a folosit judecători de la OpenAI, Anthropic, Google și xAI, iar rundele 2 și 3, judecători de la OpenAI și Google.
Fiecare răspuns primește un scor de la 0 la 100 pentru fiecare dintre cele șase criterii. Scorul general este media lor ponderată:
- Acuratețe (30%)
- Sunt corecte faptele despre produse, prețuri și politici?
- Relevanță (20%)
- Răspunde la ce a întrebat clientul?
- Completitudine (15%)
- Conține tot ce îi trebuie clientului ca să decidă?
- Utilitate (15%)
- Îl apropie pe client de o achiziție sau de o soluție?
- Ton (10%)
- Este prietenos și profesionist?
- Concizie (10%)
- Este scurt, fără să omită ceva important?
Scorurile publice folosesc doar întrebările la care au răspuns toate modelele comparate, așa că niciun model nu profită de un set de întrebări mai ușor. Runda 4 are 45 de astfel de întrebări și 540 de evaluări oarbe. Benchmarkul măsoară și timpul mediu până la un răspuns complet.
Rezultate

| # | Model | Furnizor | General | Acuratețe | Ton | Timp mediu de răspuns |
|---|---|---|---|---|---|---|
| 1 | ChatGPT 5.6 Sol | OpenAI | 71,7 | 55,4 | 86,0 | 3,5 s |
| 2 | ChatGPT 5.6 Luna | OpenAI | 69,8 | 52,7 | 88,0 | 2,8 s |
| 3 | ChatGPT 5.6 Terra | OpenAI | 69,7 | 51,3 | 89,7 | 3,2 s |
| 4 | Grok 4.1 Fast | xAI | 65,2 | 49,0 | 82,1 | 2,2 s |
| 5 | Claude Haiku 4.5 | Anthropic | 65,1 | 45,7 | 85,4 | 4,0 s |
| 6 | ChatGPT 4.1 mini | OpenAI | 63,9 | 41,6 | 85,2 | 2,9 s |
| 7 | Claude Sonnet 5 | Anthropic | 63,6 | 40,3 | 85,9 | 7,8 s |
| 8 | Gemini 3.7 Flash | 63,6 | 35,4 | 89,3 | 10,1 s | |
| 9 | Grok 4.6 | xAI | 63,0 | 41,0 | 81,1 | 49,7 s |
| 10 | Claude Opus 5 | Anthropic | 61,2 | 37,4 | 87,8 | 11,4 s |
| 11 | ChatGPT 4.1 | OpenAI | 61,2 | 34,4 | 85,3 | 2,3 s |
| 12 | Gemini 3.5 Flash-Lite | 56,8 | 32,8 | 81,3 | 1,3 s |
Scoruri 0–100, mai mare înseamnă mai bine; la timpul de răspuns, mai mic înseamnă mai bine. Fișierul CSV de la „Descărcați datele” conține toate cele șase criterii pentru fiecare model. Sursa: Chaterimo CX-LLM Benchmark, runda 4, 30 august 2026.
Ce modele conduc?
Cele trei modele ChatGPT 5.6 ocupă primele trei locuri, cu 69,7–71,7 puncte. Urmează Grok 4.1 Fast cu 65,2 și Claude Haiku 4.5 cu 65,1. Ultimul model, Gemini 3.5 Flash-Lite, este la 14,9 puncte în urma primului, așa că în această rundă alegerea modelului a făcut o diferență clară.
Pe care dintre aceste modele le puteți folosi astăzi?
Furnizorii înlocuiesc versiunile modelelor la câteva luni. La 19 octombrie 2026, patru dintre cele douăsprezece modele din runda 4 pot fi selectate în Chaterimo: Grok 4.1 Fast (65,2), ChatGPT 4.1 mini (63,9), ChatGPT 4.1 (61,2) și Gemini 3.5 Flash-Lite (56,8). Celelalte au fost înlocuite de versiuni mai noi, care nu au făcut parte din runda 4.
ChatGPT 4.1 mini este cel mai stabil model al benchmarkului. A participat la toate cele patru runde și a obținut de fiecare dată între 60,8 și 63,9.
De ce este acuratețea scorul cel mai mic?
Acuratețea verifică dacă faptele dintr-un răspuns sunt corecte: produse, prețuri, stoc, livrare și politici de retur. Chiar și cu același context din baza de cunoștințe, cel mai bun model a atins 55,4 puncte, iar cel mai slab, 32,8. Tonul, în schimb, a obținut între 81 și 90 la fiecare model.

Pentru un magazin, asta înseamnă că un răspuns fluent și prietenos nu dovedește că este și corect. Verificați faptele din răspunsurile chatbotului înainte să vă bazați pe el și păstrați complete catalogul și politicile pe care le citește.
Cât de repede răspund modelele?
Gemini 3.5 Flash-Lite a răspuns în medie în 1,3 s, iar Grok 4.1 Fast, în 2,2 s. Grok 4.6 a avut nevoie de 49,7 s, Claude Opus 5 de 11,4 s și Gemini 3.7 Flash de 10,1 s. Un client care așteaptă în fereastra de chat simte fiecare secundă, așa că viteza contează în decizie la fel de mult ca scorul.
Cum se compară cele patru runde?
Fiecare rundă folosește alt set de întrebări, așa că rezultatele din runde diferite arată o tendință, nu o comparație controlată. Claude Haiku 4.5 a obținut 64,3; 49,1; 53,5 și 65,1 în rundele 1–4; astfel de variații vin mai ales din setul de întrebări. Comparați modelele în cadrul aceleiași runde.
Limitări
- Judecătorul este un model AI, nu un om. Scorurile lui urmează criteriile de mai sus, dar poate avea puncte oarbe.
- În runda 4, un singur model judecător de la Google a evaluat toate răspunsurile, iar două dintre modelele testate provin tot de la Google. Runda următoare folosește judecători de la OpenAI, Anthropic, Google și xAI.
- 45 de întrebări sunt un eșantion mic din ce întreabă clienții.
- Rezultatele sunt valabile pentru versiunile modelelor și data rundei 4. Versiunile mai noi pot obține alte scoruri.
- Întrebările provin din magazine care folosesc Chaterimo; în alte domenii, ordinea modelelor poate fi alta.
Modele testate
- ChatGPT 5.6 Sol
- ChatGPT 5.6 Luna
- ChatGPT 5.6 Terra
- ChatGPT 4.1 mini
gpt-4.1-mini - ChatGPT 4.1
gpt-4.1 - Claude Sonnet 5
- Claude Opus 5
- Claude Haiku 4.5
- Gemini 3.7 Flash
- Gemini 3.5 Flash-Lite
gemini-3.5-flash-lite - Grok 4.1 Fast
grok-4-1-fast-non-reasoning - Grok 4.6
Descărcați datele
Cum citați
Chaterimo (2026). Cea mai bună AI pentru asistența clienți: 12 modele testate. Chaterimo CX-LLM Benchmark, 2026 Q3. https://www.chaterimo.com/ro/blog/cea-mai-buna-ai-pentru-asistenta-clienti/
Întrebări frecvente
Care AI este cea mai bună pentru asistența clienți în comerțul electronic?
În runda 4 a Chaterimo CX-LLM Benchmark (30 august 2026), ChatGPT 5.6 Sol a obținut cel mai mare scor, 71,7 din 100. Dintre modelele care pot fi selectate în Chaterimo la 19 octombrie 2026, Grok 4.1 Fast a obținut cel mai bun scor, 65,2.
Este ChatGPT sau Claude mai bun pentru asistența clienți?
În runda 4, modelele ChatGPT 5.6 au obținut 69,7–71,7, iar modelele Claude, 61,2–65,1. Diferența vine mai ales din acuratețe; la ton, toate modelele au obținut scoruri asemănătoare.
Cum se calculează scorurile benchmarkului?
Un model judecător evaluează fiecare răspuns anonim de la 0 la 100 la acuratețe, relevanță, completitudine, utilitate, ton și concizie. În runda 4, judecătorul a fost Gemini 3.1 Pro de la Google, care nu se numără printre modelele testate.
Cercetare · Asistență clienți cu AI
Starea asistenței clienți cu AI în comerțul electronic 2026
1,09 milioane de mesaje din până la 95 de magazine online, februarie – mai 2026. Cât preia AI-ul, când scriu clienții și ce modele aleg magazinele.
Articol · Modele LLM
Cum alegeți un LLM pentru asistența clienți
Acuratețe pe datele proprii, viteză, cost și ton. Cum comparați ChatGPT, Claude, Gemini și Grok într-un magazin online și le testați pe întrebări proprii.
Ghid · Cheie API OpenAI
Cum obțineți o cheie API OpenAI pentru Chaterimo
Creați un cont OpenAI Platform, adăugați credite preplătite, creați o cheie API secretă și conectați-o la Chaterimo drept cheie API proprie (BYOK).
Istoric modificări
- Ediția 2026 Q3 a Chaterimo CX-LLM Benchmark: runda 4 (30 august 2026), 12 modele, 45 de întrebări, 540 de evaluări oarbe. Au fost adăugate metodologia, limitările și descărcarea datelor.
- Publicat (prima ediție: 2.535 de evaluări oarbe a 18 modele, în trei runde).