Reihe Chaterimo CX-LLM Benchmark · Ausgabe 2026 Q3
Forschung · LLM-Modelle
Beste KI für den Kundenservice: 12 Modelle blind bewertet
ChatGPT, Claude, Gemini und Grok bei 45 echten Kundenservice-Fragen aus dem E-Commerce, blind bewertet von einem KI-Bewertungsmodell. Ausgabe 2026 Q3.
Wichtigste Erkenntnisse
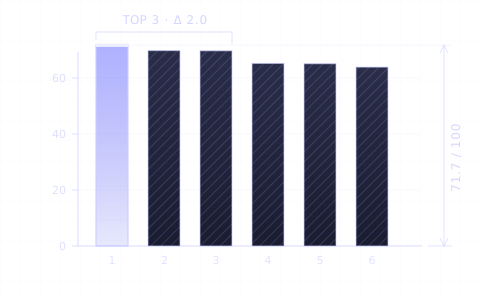
- 01In Runde 4 (30. August 2026) liegen die drei Modelle ChatGPT 5.6 mit 71,7, 69,8 und 69,7 von 100 Punkten vorn.
- 02Von den Modellen, die am 19. Oktober 2026 in Chaterimo wählbar sind, erzielte Grok 4.1 Fast den besten Wert (65,2) und antwortete im Durchschnitt in 2,2 s.
- 03Die Genauigkeit ist bei jedem Modell das schwächste Kriterium: Das beste erreichte 55,4, während alle zwölf bei der Tonalität zwischen 81 und 90 lagen.
- 04Die durchschnittlichen Antwortzeiten reichen von 1,3 s (Gemini 3.5 Flash-Lite) bis 49,7 s (Grok 4.6).
- Datenzeitraum
- Round 4, snapshot of 30 August 2026
Inhalt 11
Welches Sprachmodell beantwortet die Fragen von Kunden im E-Commerce am besten? In Runde 4 des Chaterimo CX-LLM Benchmark beantworteten 12 Modelle dieselben 45 echten Fragen aus dem Kundenservice und wurden von einem KI-Bewertungsmodell blind bewertet. Die drei Modelle ChatGPT 5.6 lagen mit 69,7–71,7 von 100 Punkten vorn. Jedes Modell erzielte seinen niedrigsten Wert bei der Genauigkeit, also beim Anteil der Fakten, die es richtig angab.
Methodik
Die Fragen stammen aus echten Kundenservice-Konversationen in Onlineshops, die Chaterimo nutzen. Jedes Modell erhält denselben System-Prompt, denselben Kontext aus der Wissensdatenbank und dieselbe Frage. Die Antworten werden anonym gekennzeichnet (Antwort A, Antwort B …) und von einem Bewertungsmodell benotet. In Runde 4 war das Gemini 3.1 Pro (Preview) von Google. Es gehört nicht zu den 12 getesteten Modellen, daher hat kein Modell seine eigene Antwort bewertet. Runde 1 nutzte Bewertungsmodelle von OpenAI, Anthropic, Google und xAI, die Runden 2 und 3 Bewertungsmodelle von OpenAI und Google.
Jede Antwort erhält für sechs Kriterien einen Wert von 0 bis 100. Der Gesamtwert ist ihr gewichteter Durchschnitt:
- Genauigkeit (30 %)
- Stimmen die Fakten über Produkte, Preise und Regeln?
- Relevanz (20 %)
- Geht die Antwort auf das ein, was der Kunde gefragt hat?
- Vollständigkeit (15 %)
- Enthält sie alles, was der Kunde für seine Entscheidung braucht?
- Nützlichkeit (15 %)
- Bringt sie den Kunden einem Kauf oder einer Lösung näher?
- Tonalität (10 %)
- Ist sie freundlich und professionell?
- Prägnanz (10 %)
- Ist sie kurz, ohne etwas Wichtiges auszulassen?
Die veröffentlichten Werte berücksichtigen nur Fragen, die jedes verglichene Modell beantwortet hat. So profitiert kein Modell von einer leichteren Auswahl an Fragen. Runde 4 umfasst 45 solcher Fragen und 540 Blindbewertungen. Der Benchmark misst außerdem die durchschnittliche Zeit bis zur vollständigen Antwort.
Ergebnisse

| # | Modell | Anbieter | Gesamt | Genauigkeit | Tonalität | Ø Antwortzeit |
|---|---|---|---|---|---|---|
| 1 | ChatGPT 5.6 Sol | OpenAI | 71,7 | 55,4 | 86,0 | 3,5 s |
| 2 | ChatGPT 5.6 Luna | OpenAI | 69,8 | 52,7 | 88,0 | 2,8 s |
| 3 | ChatGPT 5.6 Terra | OpenAI | 69,7 | 51,3 | 89,7 | 3,2 s |
| 4 | Grok 4.1 Fast | xAI | 65,2 | 49,0 | 82,1 | 2,2 s |
| 5 | Claude Haiku 4.5 | Anthropic | 65,1 | 45,7 | 85,4 | 4,0 s |
| 6 | ChatGPT 4.1 mini | OpenAI | 63,9 | 41,6 | 85,2 | 2,9 s |
| 7 | Claude Sonnet 5 | Anthropic | 63,6 | 40,3 | 85,9 | 7,8 s |
| 8 | Gemini 3.7 Flash | 63,6 | 35,4 | 89,3 | 10,1 s | |
| 9 | Grok 4.6 | xAI | 63,0 | 41,0 | 81,1 | 49,7 s |
| 10 | Claude Opus 5 | Anthropic | 61,2 | 37,4 | 87,8 | 11,4 s |
| 11 | ChatGPT 4.1 | OpenAI | 61,2 | 34,4 | 85,3 | 2,3 s |
| 12 | Gemini 3.5 Flash-Lite | 56,8 | 32,8 | 81,3 | 1,3 s |
Werte 0–100, höher ist besser; bei der Antwortzeit ist niedriger besser. Die CSV-Datei unter „Daten herunterladen“ enthält alle sechs Kriterien für jedes Modell. Quelle: Chaterimo CX-LLM Benchmark, Runde 4, 30. August 2026.
Welche Modelle liegen vorn?
Die drei Modelle ChatGPT 5.6 belegen mit 69,7–71,7 Punkten die ersten drei Plätze. Es folgen Grok 4.1 Fast mit 65,2 und Claude Haiku 4.5 mit 65,1. Das letzte Modell, Gemini 3.5 Flash-Lite, liegt 14,9 Punkte hinter dem ersten. In dieser Runde machte die Wahl des Modells also einen deutlichen Unterschied.
Welche dieser Modelle können Sie heute nutzen?
Die Anbieter ersetzen ihre Modellversionen alle paar Monate. Am 19. Oktober 2026 sind vier der zwölf Modelle aus Runde 4 in Chaterimo wählbar: Grok 4.1 Fast (65,2), ChatGPT 4.1 mini (63,9), ChatGPT 4.1 (61,2) und Gemini 3.5 Flash-Lite (56,8). Die übrigen wurden durch neuere Versionen ersetzt, die nicht an Runde 4 teilnahmen.
ChatGPT 4.1 mini ist das stabilste Modell des Benchmarks. Es nahm an allen vier Runden teil und erzielte jedes Mal zwischen 60,8 und 63,9 Punkte.
Warum ist die Genauigkeit der niedrigste Wert?
Die Genauigkeit prüft, ob die Fakten in einer Antwort stimmen: Produkte, Preise, Lagerbestand, Lieferung und Rückgaberegeln. Selbst mit demselben Kontext aus der Wissensdatenbank erreichte das beste Modell 55,4 Punkte und das schwächste 32,8. Bei der Tonalität lagen dagegen alle Modelle zwischen 81 und 90.

Für einen Onlineshop heißt das: Eine flüssige, freundliche Antwort beweist nicht, dass sie richtig ist. Prüfen Sie die Fakten in den Antworten Ihres Chatbots, bevor Sie ihm vertrauen, und halten Sie den Katalog und die Regeln, die er liest, vollständig.
Wie schnell antworten die Modelle?
Gemini 3.5 Flash-Lite antwortete im Durchschnitt in 1,3 s und Grok 4.1 Fast in 2,2 s. Grok 4.6 brauchte 49,7 s, Claude Opus 5 11,4 s und Gemini 3.7 Flash 10,1 s. Ein Kunde, der im Chatfenster wartet, bemerkt jede Sekunde. Die Geschwindigkeit gehört deshalb genauso zur Entscheidung wie der Wert.
Wie lassen sich die vier Runden vergleichen?
Jede Runde verwendet andere Fragen. Ergebnisse über mehrere Runden zeigen daher einen Trend, keinen kontrollierten Vergleich. Claude Haiku 4.5 erzielte in den Runden 1 bis 4 die Werte 64,3, 49,1, 53,5 und 65,1; solche Schwankungen entstehen vor allem durch die Auswahl der Fragen. Vergleichen Sie Modelle innerhalb einer Runde.
Einschränkungen
- Das Bewertungsmodell ist eine KI, kein Mensch. Seine Werte folgen den Kriterien oben, aber es kann blinde Flecken haben.
- In Runde 4 bewertete ein einziges Bewertungsmodell von Google alle Antworten, und zwei der getesteten Modelle stammen ebenfalls von Google. Die nächste Runde nutzt Bewertungsmodelle von OpenAI, Anthropic, Google und xAI.
- 45 Fragen sind eine kleine Stichprobe dessen, was Kunden fragen.
- Die Ergebnisse gelten für die Modellversionen und das Datum von Runde 4. Neuere Versionen können anders abschneiden.
- Die Fragen stammen aus Onlineshops, die Chaterimo nutzen; in anderen Branchen kann die Rangfolge der Modelle anders aussehen.
Getestete Modelle
- ChatGPT 5.6 Sol
- ChatGPT 5.6 Luna
- ChatGPT 5.6 Terra
- ChatGPT 4.1 mini
gpt-4.1-mini - ChatGPT 4.1
gpt-4.1 - Claude Sonnet 5
- Claude Opus 5
- Claude Haiku 4.5
- Gemini 3.7 Flash
- Gemini 3.5 Flash-Lite
gemini-3.5-flash-lite - Grok 4.1 Fast
grok-4-1-fast-non-reasoning - Grok 4.6
Daten herunterladen
Zitiervorschlag
Chaterimo (2026). Beste KI für den Kundenservice: 12 Modelle blind bewertet. Chaterimo CX-LLM Benchmark, 2026 Q3. https://www.chaterimo.com/de/blog/beste-ki-fuer-kundenservice/
Häufige Fragen
Welche KI ist die beste für den Kundenservice im E-Commerce?
In Runde 4 des Chaterimo CX-LLM Benchmark (30. August 2026) erzielte ChatGPT 5.6 Sol mit 71,7 von 100 den höchsten Wert. Von den Modellen, die am 19. Oktober 2026 in Chaterimo wählbar sind, schnitt Grok 4.1 Fast mit 65,2 am besten ab.
Ist ChatGPT oder Claude besser für den Kundenservice?
In Runde 4 erzielten die Modelle ChatGPT 5.6 Werte von 69,7–71,7, die Claude-Modelle 61,2–65,1. Der Unterschied entsteht vor allem bei der Genauigkeit; bei der Tonalität lagen alle Modelle nah beieinander.
Wie wird der Benchmark bewertet?
Ein Bewertungsmodell vergibt für jede anonyme Antwort Werte von 0 bis 100 für Genauigkeit, Relevanz, Vollständigkeit, Nützlichkeit, Tonalität und Prägnanz. In Runde 4 war das Gemini 3.1 Pro von Google, das nicht zu den getesteten Modellen gehört.
Forschung · KI-Kundenservice
Stand des KI-Kundenservice im E-Commerce 2026
1,09 Mio. Kundennachrichten aus bis zu 95 Onlineshops, Februar bis Mai 2026. Wie viel die KI übernimmt, wann Kunden fragen und welche Modelle Shops nutzen.
Artikel · LLM-Modelle
So wählen Sie ein Sprachmodell (LLM) für den Kundenservice
Genauigkeit bei Ihren Daten, Tempo, Kosten, Tonalität: So vergleichen Sie ChatGPT, Claude, Gemini und Grok für Ihren Shop und testen sie mit Ihren Fragen.
Anleitung · OpenAI-API-Schlüssel
So erhalten Sie einen OpenAI-API-Schlüssel für Chaterimo
Konto auf der OpenAI Platform anlegen, Prepaid-Guthaben aufladen, geheimen API-Schlüssel erstellen und als eigenen Schlüssel (BYOK) in Chaterimo nutzen.
Änderungen
- Ausgabe 2026 Q3 des Chaterimo CX-LLM Benchmark: Runde 4 (30. August 2026), 12 Modelle, 45 Fragen, 540 Blindbewertungen. Methodik, Einschränkungen und Daten zum Herunterladen ergänzt.
- Veröffentlicht (erste Ausgabe: 2.535 Blindbewertungen von 18 Modellen in drei Runden).