Séria Chaterimo CX-LLM Benchmark · edícia 2026 Q3
Výskum · LLM modely
Najlepšia AI pre zákaznícku podporu: slepý test 12 modelov
ChatGPT, Claude, Gemini a Grok na 45 skutočných otázkach zákazníckej podpory e-shopov, ohodnotené naslepo AI porotcom. Vydanie 2026 Q3.
Kľúčové zistenia
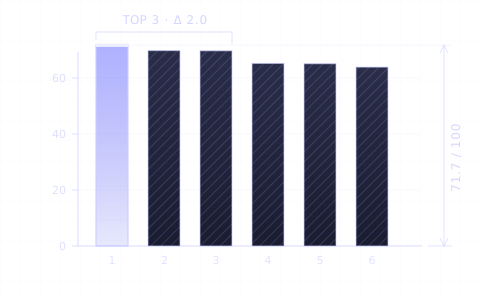
- 01Vo 4. kole (30. augusta 2026) vedú tri modely ChatGPT 5.6 so skóre 71,7, 69,8 a 69,7 bodu zo 100.
- 02Z modelov, ktoré sa dali 19. októbra 2026 vybrať v aplikácii Chaterimo, dosiahol najlepšie skóre Grok 4.1 Fast (65,2) a odpovedal v priemere za 2,2 s.
- 03Presnosť je najslabšie kritérium každého modelu: najlepší dosiahol 55,4, zatiaľ čo v tóne malo všetkých dvanásť modelov skóre od 81 do 90.
- 04Priemerný čas odpovede sa pohybuje od 1,3 s (Gemini 3.5 Flash-Lite) po 49,7 s (Grok 4.6).
- Obdobie dát
- Round 4, snapshot of 30 August 2026
Obsah 11
Ktorý jazykový model odpovedá zákazníkom e-shopov najlepšie? V 4. kole Chaterimo CX-LLM Benchmark odpovedalo 12 modelov na rovnakých 45 skutočných otázok zo zákazníckej podpory a ich odpovede naslepo ohodnotil AI porotca, teda hodnotiaci AI model. Viedli tri modely ChatGPT 5.6 so skóre 69,7 až 71,7 bodu zo 100. Každý model mal najnižšie skóre v presnosti, teda v podiele faktov, ktoré uviedol správne.
Metodika
Otázky pochádzajú zo skutočných konverzácií zákazníckej podpory v e-shopoch, ktoré používajú Chaterimo. Každý model dostane rovnaký systémový prompt, rovnaký kontext zo znalostnej bázy a rovnakú otázku. Odpovede sú anonymne označené (Odpoveď A, Odpoveď B …) a hodnotí ich hodnotiaci model. Vo 4. kole hodnotil Gemini 3.1 Pro (preview) od Googlu, ktorý nepatrí medzi 12 testovaných modelov, takže žiadny model nehodnotil vlastnú odpoveď. V 1. kole hodnotili modely od OpenAI, Anthropic, Google a xAI, v 2. a 3. kole modely od OpenAI a Google.
Každá odpoveď dostane skóre od 0 do 100 v šiestich kritériách. Celkové skóre je ich vážený priemer:
- Presnosť (30 %)
- Sú fakty o produktoch, cenách a pravidlách správne?
- Relevancia (20 %)
- Odpovedá odpoveď na to, na čo sa zákazník pýtal?
- Úplnosť (15 %)
- Obsahuje všetko, čo zákazník potrebuje na rozhodnutie?
- Užitočnosť (15 %)
- Posúva zákazníka k nákupu alebo k riešeniu?
- Tón (10 %)
- Je priateľská a profesionálna?
- Stručnosť (10 %)
- Je krátka a nevynecháva nič dôležité?
Verejné skóre počíta len s otázkami, na ktoré odpovedali všetky porovnávané modely, aby žiadny model nezískal výhodu ľahšou skladbou otázok. Vo 4. kole je takých otázok 45 a slepých hodnotení 540. Benchmark meria aj priemerný čas do úplnej odpovede.
Výsledky

| # | Model | Poskytovateľ | Celkovo | Presnosť | Tón | Priem. odpoveď |
|---|---|---|---|---|---|---|
| 1 | ChatGPT 5.6 Sol | OpenAI | 71,7 | 55,4 | 86,0 | 3,5 s |
| 2 | ChatGPT 5.6 Luna | OpenAI | 69,8 | 52,7 | 88,0 | 2,8 s |
| 3 | ChatGPT 5.6 Terra | OpenAI | 69,7 | 51,3 | 89,7 | 3,2 s |
| 4 | Grok 4.1 Fast | xAI | 65,2 | 49,0 | 82,1 | 2,2 s |
| 5 | Claude Haiku 4.5 | Anthropic | 65,1 | 45,7 | 85,4 | 4,0 s |
| 6 | ChatGPT 4.1 mini | OpenAI | 63,9 | 41,6 | 85,2 | 2,9 s |
| 7 | Claude Sonnet 5 | Anthropic | 63,6 | 40,3 | 85,9 | 7,8 s |
| 8 | Gemini 3.7 Flash | 63,6 | 35,4 | 89,3 | 10,1 s | |
| 9 | Grok 4.6 | xAI | 63,0 | 41,0 | 81,1 | 49,7 s |
| 10 | Claude Opus 5 | Anthropic | 61,2 | 37,4 | 87,8 | 11,4 s |
| 11 | ChatGPT 4.1 | OpenAI | 61,2 | 34,4 | 85,3 | 2,3 s |
| 12 | Gemini 3.5 Flash-Lite | 56,8 | 32,8 | 81,3 | 1,3 s |
Skóre 0–100, vyššie je lepšie; pri čase odpovede je lepší nižší. Súbor CSV v časti „Stiahnuť dáta“ obsahuje všetkých šesť kritérií pre každý model. Zdroj: Chaterimo CX-LLM Benchmark, 4. kolo, 30. augusta 2026.
Ktoré modely vedú?
Tri modely ChatGPT 5.6 obsadili prvé tri miesta so skóre 69,7 až 71,7 bodu. Nasleduje Grok 4.1 Fast so skóre 65,2 a Claude Haiku 4.5 so skóre 65,1. Posledný model, Gemini 3.5 Flash-Lite, zaostáva za prvým o 14,9 bodu, takže v tomto kole mal výber modelu zreteľný vplyv.
Ktoré z týchto modelov môžete použiť dnes?
Poskytovatelia nahrádzajú verzie modelov každých niekoľko mesiacov. K 19. októbru 2026 sa dajú v aplikácii Chaterimo vybrať štyri z dvanástich modelov 4. kola: Grok 4.1 Fast (65,2), ChatGPT 4.1 mini (63,9), ChatGPT 4.1 (61,2) a Gemini 3.5 Flash-Lite (56,8). Ostatné nahradili novšie verzie, ktoré sa 4. kola nezúčastnili.
ChatGPT 4.1 mini je najstabilnejší model benchmarku. Zúčastnil sa všetkých štyroch kôl a zakaždým dosiahol skóre od 60,8 do 63,9.
Prečo má presnosť najnižšie skóre?
Presnosť kontroluje, či sú fakty v odpovedi správne: produkty, ceny, sklad, doprava a pravidlá vrátenia tovaru. Aj s rovnakým kontextom zo znalostnej bázy dosiahol najlepší model 55,4 bodu a najslabší 32,8. Tón mal naproti tomu u každého modelu skóre od 81 do 90.

Pre e-shop to znamená, že plynulá a priateľská odpoveď ešte nie je dôkazom správnej odpovede. Skôr než chatbotovi začnete dôverovať, skontrolujte fakty v jeho odpovediach a udržiavajte katalóg a pravidlá, z ktorých čerpá, úplné.
Ako rýchlo modely odpovedajú?
Gemini 3.5 Flash-Lite odpovedal v priemere za 1,3 s a Grok 4.1 Fast za 2,2 s. Grok 4.6 potreboval 49,7 s, Claude Opus 5 11,4 s a Gemini 3.7 Flash 10,1 s. Zákazník, ktorý čaká v chatovacom okne, vníma každú sekundu, preto rýchlosť patrí do rozhodovania rovnako ako skóre.
Ako sa líšia štyri kolá?
Každé kolo používa inú sadu otázok, takže výsledky naprieč kolami ukazujú trend, nie kontrolované porovnanie. Claude Haiku 4.5 dosiahol v 1. až 4. kole skóre 64,3, 49,1, 53,5 a 65,1; také výkyvy spôsobuje hlavne skladba otázok. Modely porovnávajte v rámci jedného kola.
Obmedzenia
- Porotcom je AI model, nie človek. Jeho skóre sa riadi uvedenými kritériami, ale môže mať slepé miesta.
- Vo 4. kole hodnotil všetky odpovede jediný model od Googlu a dva z testovaných modelov sú tiež od Googlu. V ďalšom kole budú hodnotiť modely od OpenAI, Anthropic, Google a xAI.
- 45 otázok je malá vzorka toho, na čo sa zákazníci pýtajú.
- Výsledky platia pre verzie modelov a dátum 4. kola. Novšie verzie môžu dosiahnuť iné skóre.
- Otázky pochádzajú z e-shopov, ktoré používajú Chaterimo; v iných odvetviach môže byť poradie modelov iné.
Testované modely
- ChatGPT 5.6 Sol
- ChatGPT 5.6 Luna
- ChatGPT 5.6 Terra
- ChatGPT 4.1 mini
gpt-4.1-mini - ChatGPT 4.1
gpt-4.1 - Claude Sonnet 5
- Claude Opus 5
- Claude Haiku 4.5
- Gemini 3.7 Flash
- Gemini 3.5 Flash-Lite
gemini-3.5-flash-lite - Grok 4.1 Fast
grok-4-1-fast-non-reasoning - Grok 4.6
Dáta na stiahnutie
Ako citovať
Chaterimo (2026). Najlepšia AI pre zákaznícku podporu: slepý test 12 modelov. Chaterimo CX-LLM Benchmark, 2026 Q3. https://www.chaterimo.com/sk/blog/najlepsia-ai-pre-zakaznicku-podporu/
Časté otázky
Ktorá AI je najlepšia pre zákaznícku podporu e-shopu?
Vo 4. kole Chaterimo CX-LLM Benchmark (30. augusta 2026) dosiahol najvyššie skóre ChatGPT 5.6 Sol, 71,7 zo 100. Z modelov, ktoré sa dali 19. októbra 2026 vybrať v aplikácii Chaterimo, dosiahol najlepšie skóre Grok 4.1 Fast, 65,2.
Je pre zákaznícku podporu lepší ChatGPT, alebo Claude?
Vo 4. kole dosiahli modely ChatGPT 5.6 skóre 69,7 až 71,7, modely Claude 61,2 až 65,1. Rozdiel spôsobila hlavne presnosť; v tóne mali všetky modely podobné skóre.
Ako sa benchmark hodnotí?
Hodnotiaci model dá každej anonymnej odpovedi skóre od 0 do 100 za presnosť, relevanciu, úplnosť, užitočnosť, tón a stručnosť. Vo 4. kole hodnotil Gemini 3.1 Pro od Googlu, ktorý nepatrí medzi testované modely.
Výskum · AI zákaznícka podpora
Stav AI zákazníckej podpory v e-commerce 2026
1,09 milióna správ zákazníkov z až 95 e-shopov, február – máj 2026. Koľko zvládne AI, kedy sa zákazníci pýtajú a aké modely e-shopy používajú.
Článok · LLM modely
Ako vybrať LLM pre zákaznícku podporu
Presnosť na vašich dátach, rýchlosť, cena a tón. Ako porovnať ChatGPT, Claude, Gemini a Grok pre e-shop a otestovať ich na vlastných otázkach.
Návod · API kľúč Gemini
Ako získať API kľúč Gemini pre Chaterimo
Prihláste sa do Google AI Studio, vytvorte API kľúč Gemini, nastavte fakturáciu pre jeho projekt a pripojte kľúč k Chaterimu ako vlastný kľúč (BYOK).
Zoznam zmien
- Vydanie 2026 Q3 série Chaterimo CX-LLM Benchmark: 4. kolo (30. augusta 2026), 12 modelov, 45 otázok, 540 slepých hodnotení. Doplnená metodika, obmedzenia a dáta na stiahnutie.
- Zverejnené (prvé vydanie: 2 535 slepých hodnotení 18 modelov v troch kolách).